Rozumíme třídám zesílení a jejich účelu
Posílení– jedná se o speciální mechanismus centrálního nervového systému, který přispívá k úplnějšímu, efektivnějšímu a spolehlivějšímu uspokojování potřeb.
Rozlišování mezi pojmy „úplný“ a „účinný“
„Úplný“ a „účinný“ není totéž. Zde je příklad. Král Pyrrhus (319-273 př. Kr.) v roce 279 př. Kr. vyhrál nad Římany u Auscula: za cenu obrovských ztrát. Rozrušený Pyrrhus, jak říká legenda, zvolal: „Další takové vítězství a už mi nezbudou žádné jednotky.“ Takže došlo k vítězství? – Byl. Plný? – Plný. Co ještě? Je nutné zachovat možnost vyhrávat vítězství do budoucna. To už ale nebylo možné. V důsledku toho bylo vítězství neúčinné: nakonec tím byl Pyrrhus oslaben více než Římané svou porážkou.
Další příklad na každodenní úrovni. Muž dostal hlad a vešel do prvního stravovacího zařízení, na které narazil. Jídlo bylo chutné a uspokojující, ale platba se ukázala být třikrát vyšší, než očekával. Byla jeho potřeba jídla uspokojena? – Ano, úplně. Ale bylo to skutečně uspokojeno? – Ne: příliš vysoká cena. Přirozeně, že v budoucnu bude tato osoba při výběru místa k jídlu opatrnější. Jeho stav byl přitom nejednoznačný: na jedné straně jeho vjemy naznačovaly naprosté (kvalitní) uspokojení potřeby jídla, na druhé straně emoce (otrava, zklamání) napovídaly: už sem nikdy nechoď! Co bude tento člověk dělat v budoucnu na základě této životní zkušenosti? Hledejte místo, kde je jídlo stejně chutné, ale kde bude nižší cena.
Existují dvě úrovně posílení: na úrovni pocitů a na úrovni emocí. Pocity vám říkají: hledejte místo, kde kvalita jídla není o nic horší. Emoce nám říkají: to nestačí – podívejte se, kde to bude levnější při stejné kvalitě!
Další možnost je také možná: při stejně vysoké kvalitě služeb se náklady ukázaly být nižší, než člověk očekával. Potom toto zařízení navštíví „se zvláštním potěšením“. Proč? Protože příjemná myšlenka na to, že je to levné, přidá na pozitivních pocitech z lahodného jídla.
Čtyři úrovně vyztužení
Celkově se během evoluce vyvinuly čtyři úrovně posílení: primární hédonická, emocionální, volní, morální. Každý z nich má sféru svého projevu. Primární hédonické posílení podporuje nejúplnější uspokojení potřeb. Emoční posilování přispívá k nejúčinnějšímu uspokojení potřeb. Vůlí posilování pomáhá dovést aktivitu zaměřenou na uspokojení potřeby k úspěšnému dokončení: zajišťuje její odolnost vůči rušení a rozptylování. Není náhodou, že v obtížných podmínkách jsou při dosahování „svých“ úspěšnější ti, kteří projevují rozvinuté vlastnosti pevné vůle (vytrvalost, optimismus, odhodlání). Následkem toho dobrovolné posilování přispívá k nejkvalitnějšímu uspokojení potřeb: úplnému a efektivnímu, navzdory nepříznivým podmínkám. Morální posílení podporuje nejlepší interakci jednotlivců v procesu uspokojování jejich potřeb.
Primární hédonické posílení je přítomno u všech tvorů schopných chování. Všechna zvířata, která dosáhla určité úrovně složitosti, mají emoční posílení a zvířata mají také poměrně bohaté projevy emocí. Podrobně to popsal Charles Darwin (1809-1882). Jeho hlavní díla: „Původ druhů přírodním výběrem“, „Původ člověka a sexuální selekce“, „Výraz emocí u člověka a zvířat“. Zvířata mají zároveň základy dobrovolného posílení. Pokud jde o morální posílení, zvířata toho nejsou schopna kvůli nedostatečně vysoké úrovni vývoje centrálního nervového systému. Počátky takového posilování však lze spatřovat v situacích interakce a vzájemné pomoci mezi zvířaty: morální posilování je faktorem účinnosti společného uspokojování potřeb: nastavuje hranice soutěže a soupeření.
Hédonický princip psychiky je základem všech druhů posilování
Základem všech druhů posilování je hédonický princip psychiky. Ve svém funkčním vývoji a konstrukčním a morfologickém návrhu prochází cestou, která umožňuje všechny čtyři typy výztuže. V lidském mozku bylo objeveno přes šest set bodů, jejichž podráždění elektrickým proudem způsobuje příjemné (obvykle) nebo nepříjemné pocity. To jsou body zájmu, které hrají klíčovou roli v mechanismu hodnocení. Není náhodou, že člověku není lhostejné podstatně větší množství předmětů a jevů okolního světa, než kterýkoli jiný tvor.
Primární hédonický princip v jeho vývoji začíná „příjemným-nepříjemným“, k němu se připojuje schopnost rozlišovat „dobro-zlo“ a dále schopnost rozlišovat „dobro-zlo“. Přirozeně, poslední dva rozdíly jsou jedinečné pro lidi.
Podmínky pro vznik motivační síly hodnocení
Motivační síla hodnocení je možná pouze tehdy, je-li jeho hédonický obsah spojen s vzbuzením potřeby. Pokud tam není, zůstává hédonismus člověka na úrovni příjemných snů nebo myšlenek na příjemné věci (pokud jeho pozornost nezaměstnává něco jiného). Ale nebude mít energii jednat ve směru této příjemné věci.
Každý tvor ve svém životě usiluje o příjemné a vyhýbá se nepříjemnému: opak je v zásadě nemožný, neexistuje-li jiná potřeba, kvůli níž by člověk mohl snášet nepříjemné. Ochota přijmout nepříjemné má pod sebou vždy něco příjemného: jako perspektivu. Je známo, že člověk, který usiluje o něco vzdáleně příjemného, může jít k něčemu bezprostředně nepříjemnému. Například absolvování bolestivého zákroku zubního ošetření je právě proto, aby vás v budoucnu nebolely zuby. Faktem je, že bolest během zubního ošetření dostává nový význam: význam známky zlepšení zdraví. Pokud by člověk vždy a bezpodmínečně usiloval jen o to, co mu bylo příjemné (jak tvrdí zastánci hédonismu), bylo by to nemožné. Ale právě schopnost překročit meze aktuální situace mu dává sílu prožít a překonat nepříjemné – pro následnou pohodu, která je hodnocena jako obecně příjemný stav.
• Centrální nervový systém má speciální mechanismus, který přispívá k úplnějšímu, efektivnějšímu a spolehlivějšímu uspokojování potřeb. Tento mechanismus je zesílení.
• Lidé mají čtyři úrovně posílení. Primární hédonické posílení podporuje úplnější, emocionální – efektivnější, volní – spolehlivější uspokojení potřeb. Morální posilování pomáhá koordinovat činnost jednotlivců v situacích společného uspokojování jejich potřeb.
Dva druhy výztuže
Nyní o dvou typech výztuže: podle průběhu cyklu potřeby. Jedná se o anticipační posílení (před zahájením akce a do jejího dokončení) a konečné posílení: jako její subjektivní výsledek.
Anticipační posílení se projevuje takovými emocemi, jako je inspirace, nadšení, sebevědomí a očekávání. Je jasné, že to vše je možné jen do té doby, než je potřeba uspokojena a je důležité věc dotáhnout do konce.
Konečná výztuž má jiný charakter: zaznamenává skutečnost, že v důsledku akcí bylo získáno přesně to, co bylo požadováno. Tím zaznamenává (konsoliduje) celý sled akcí, které vedly k úspěšnému výsledku – úplnému uspokojení potřeby. Tato povaha konečného posílení je zřejmá z takových emocí, jako je triumf, hrdost, radost z vítězství, „pocit dobře vykonané práce“ a někdy i sebeuspokojení. Je jasné, že je stejně absurdní být šťastný a hrdý před tím, než je práce hotová, a projevovat nadšení po jejím dokončení.
Vztah mezi dvěma typy výztuže
Existují tedy dva typy posilování: ten, který „hledí“ dopředu a dává sílu k dosažení požadovaného výsledku, a ten, který se ohlíží zpět a zaznamenává (jako úspěšnou) kombinaci akcí, které vedly k jeho úspěšnému dosažení. Anticipační posilování nám následně umožňuje neopouštět to, co jsme cestou začali, i když někdy může potřeba vzrušení slábnout, a závěrečné posílení zaznamenává zážitek z úspěšných akcí a jejich samotný obsah, stejně jako okamžik dosažení výsledku.
Otázkou je, co přesně tyto dva typy výztuže vyztužují? Anticipační posiluje vzbuzení potřeby, přidává k jeho energii energii emocí, a má tedy převážně energeticko-silový charakter. Finální zpevnění posiluje hédonický efekt dosažení požadovaného výsledku, a má tedy výraznější hédonický potenciál. Závěrečné posílení přirozeně není motivující, ale uklidňující, uklidňující a uvolňující.
Běžný zdroj hédonické energie v centrálním nervovém systému
Zdá se, že v centrálním nervovém systému existuje společný zdroj hédonické energie: pro pocity i emoce. Tento předpoklad podporují ony dobře známé případy, kdy jsou zkušenosti jednotlivce během úkolu tak intenzivní, že po dosažení požadovaného výsledku „už nemá sílu se radovat“. Radost z očekávání a radost z očekávání jsou totiž často silnější než potěšení a radost z toho, čeho bylo dosaženo. Tento kontrast může jednotlivce dokonce vést ke zklamání. Je také přirozené, že u různých jedinců je zesílení obou typů vyjádřeno odlišně: u některých je výraznější anticipační zesílení, u jiných je výraznější finální zesílení. První, prožívající radost z boje, radost ze soutěžení, vzrušení, nadšení, se od toho izolují, takže konečný výsledek je jimi chladnokrevně vnímán: jako něco „samozřejmého“, a tedy nevyžadujícího žádné zkušenosti.
Příklady hédonického účinku anticipačního posilování
Mezi jedince tohoto mentálního typu patří ti, kteří se věnují hraní rulety, sázení na koňských dostizích a běžní návštěvníci kasin: pro ně je hlavní hedonické naplnění stavu očekávání, zatímco samotný obsah výsledku je vnímán jim víceméně lhostejně. Není náhoda, že poté, co hodně vyhráli, usednou znovu ke hře: utrácet peníze jiným způsobem než hazardem jim moc radosti nedělá.
Hédonické riziko, radost z pronásledování, radost z překonávání, hazard – to vše jsou příklady síly (hedonického účinku) anticipačního posilování. A k podobnému mentálnímu typu patří i Don Juan: hlavní je pro něj radost z honičky a očekávání úspěchu. Konečný (biologický) výsledek pro něj nemá velký význam: není náhoda, že okamžitě přechází na jiný sexuální objekt, a pokud je s něčím ve vztahu k ženskému pohlaví spokojen, je to samotná rasa, pronásledování. Nikdy nevidí, co je skutečným obsahem těchto činů: navázání pevných vazeb se ženou a objevení se potomků. Není náhoda, že jsme o četných „vítězstvích Dona Juana“ slyšeli dost, ale málokdo ví něco o jeho dětech. Kdyby byly, romanopiscům by to neuniklo. To znamená, že si nikdo nemyslí, že takový jedinec může mít potomky.
Blaženost je intenzivní prožitek životní pohody.
Předvídavé posílení je hédonicky doplněno o „pocit“ svalové radosti, potěšení z návalu nebo „nadbytku“ síly. Závěrečné posílení je hédonicky doplněno zvláštním zážitkem blaženosti a příznivého psychofyziologického stavu (ve skutečnosti je potřeba uspokojena!). Blaženost lze definovat jako intenzivní prožitek životní pohody díky fúzi pozitivních vjemů a pozitivních emocí na pozadí celkového klidu (když „nikdo neruší“).
Stav blaženosti má tři kvality:
blaženost jako pobídka k opakování činů, které k tomu vedly;
blaženost jako hédonický standard (viz níže) pro budoucnost: jedinec brzy „nesouhlasí“ s ničím menším a s ničím jiným se již nespokojí;
blaženost jako superoptimální (subjektivní) psychofyziologický stav těla, kdy „nic jiného není potřeba“.
Rozlišení posil podle jejich dočasné povahy
Je užitečné si všimnout dalšího důležitého rozdílu mezi proaktivním a konečným typem výztuže. Předvídavé posílení je intenzivní, ale svou povahou krátkodobé: je navrženo tak, aby posílilo každou jednotlivou fázi akce, aniž by zasahovalo do přechodu z jedné postavy na druhou. Pokud by anticipační posilování bylo dlouhodobé, bránilo by jedinci ve výběru nových metod jednání na cestě. V důsledku toho má anticipační posilování kvantovaný charakter: každá akce v jejich společném řetězci, každý záměr, každá touha je posílena. Každý z nás měl možnost se přesvědčit, že nával nadšení či naděje se může po cestě mnohokrát opakovat, a pokud se to nepodaří, vystřídá krátké období sklíčenosti a pak nové návaly nadšení.
Vzhledem k tomu, že posilující (hédonický) účinek anticipačního zesílení by měl být krátkodobý, je citlivý a málo odolný vůči rušivým faktorům: tento druh „vysokého“ se snadno „odlomí“. Ne náhodou jsme přešli k těmto termínům z drogového žargonu. Faktem je, že při srovnání účinků dvou drog: heroinu a kokainu je jasně patrná existence dvou typů posilování. Heroin je typická „konečná“ droga, zatímco kokain je „proaktivní“ droga. Účinky každého z těchto léků poskytují přesvědčivý model dvou typů zesílení.
Na rozdíl od anticipativního posilování má finální posilování dlouhodobý charakter a je docela odolné vůči všem druhům dalších faktorů: koneckonců je spojeno s obecně příznivým stavem těla, který se podle plánu přírody vyskytuje jako výsledek uspokojení potřeby. Účinek drogy tohoto typu je přímým klamem tělem a psychikou, ale subjektivně si to jedinec nemyslí. Toto je nebezpečí. Jedinec si zvyká na umělou blaženost a snaží se ji prožívat v budoucnu jakýmkoliv způsobem. A cenově nejdostupnější je užívání další dávky. Účinek léku „konečného“ typu tedy trvá několik hodin, a nikoli minut, jako účinek léků „pokročilého“ typu.
Příklady vícečasových výztuh
Myslím, že by bylo užitečné porovnat účinek alkoholu s účinkem nikotinu: stav alkoholové intoxikace trvá několik hodin a někdo zvyklý na nikotin je nucen kouřit až několikrát za hodinu a tak dále po celou dobu bdění. období.
Narkotický účinek heroinu a kokainu má dvě fáze. Heroin – fáze akutního potěšení a poté fáze superoptimálního psychofyziologického stavu, prožívaného jako „blaženost“. Kokain je krátkodobá fáze akutního potěšení, která je rychle nahrazena fází akutní nelibosti, která vede k novému užití. Užívání kokainu má tedy „přejížďkovou“ povahu: jedinec, který právě zažil potěšení z jeho užívání, je okamžitě nucen to zopakovat kvůli ostré hédonické nevýhodě. A tak – mnoho cyklů během několika hodin nebo dokonce dnů až do stavu úplného vyčerpání a nuceného přerušení používání (také na několik hodin nebo dní).
• Zesílení má dva typy, které odpovídají fázím cyklu potřeby: „pokročilý“ a „konečný“. První „hledí“ dopředu a dává jednotlivci další sílu a energii k dosažení požadovaného výsledku. Druhý se „ohlíží“ zpět a zaznamenává povahu akcí, které vedly k úspěchu – uspokojení potřeby.
• Konečné posílení je charakterizováno trváním: podle stavu těla v případě uspokojení potřeby a dočasného odmítnutí jiných projevů činnosti. Nejintenzivnější stav konečného posílení má charakter blaženosti. Anticipační posilování je intenzivní, ale krátkodobé povahy, což nebrání jedinci přejít z jednoho typu činnosti na jiný v průběhu uspokojování potřeby a každý nový typ činnosti lze posílit samostatně.
Spolu s úrovněmi a typy má zesílení také modalitu: zesílení může být pozitivní nebo negativní. Rozdíl mezi nimi je v tom, že zatímco jedinec usiluje o pozitivní, negativnímu se vyhýbá. Výše jsme hovořili o pozitivním posílení. Důležitou roli při zvyšování efektivity akcí hraje i negativita. Nikdo nebude usilovat o nepříjemné pocity nebo nelibost, ale bude se jim vyhýbat. A to je často užitečné. Navíc nedochází ke zneužívání negativního posilování (jako je tomu u drogové závislosti s pozitivním posilováním).
Vlastnosti výskytu nepříjemných pocitů a emocí
Jak vznikají nepříjemné pocity a nepříjemné emoce? Dlouhotrvající stav nespokojenosti s jakoukoli důležitou potřebou vytváří stav duševního napětí, který je naplněn nepříjemnými pocity – od bolesti až po celkové nepohodlí. Selhání v průběhu jednání způsobují negativní emoce: hněv, vztek, mrzutost, zklamání, pochybnosti. Negativní posilování má tedy také motivační sílu, ale jiným směrem: nutí vás změnit povahu jednání, které dlouhodobě nevedou k uspokojení potřeby, hledat nové způsoby a prostředky k jejímu uspokojení. . V důsledku toho, když jedinec usiluje o stejný cíl, negativní posilování přispívá k „utloukání“ neefektivních metod jednání, stejně jako k hledání jiných, účinnějších. Negativní posilování tedy zvyšuje efektivitu uspokojování potřeb rozšířením pole výběru objektů interakce a typů této interakce samotné. Ne nadarmo se říká: „selhání zbystří mysl.“
Zvláštností negativního posilování je, že ačkoliv je subjektivně nepříjemné, je objektivně velmi užitečné. Zároveň ve skutečnosti funguje pro pozitivní posílení: tím, že vybízí k hledání nových, účinnějších způsobů uspokojení potřeby, podporuje aktivitu jedince, dokud se nezmění v pozitivní. V důsledku toho jsou tyto dva typy posilování asymetrické a vysvětluje se to tím, že zatímco život pokračuje, dominuje pozitivní hédonický princip – skutečností uspokojování potřeb, bez nichž by pokračování života nebylo možné.
• Mechanismy pozitivního a negativního posilování mají svůj vlastní energetický potenciál a vzájemně se doplňují během cyklu potřeby a společně přispívají k jeho úspěšnému dokončení.
• Subjektivně nepříjemné pocity a emoce negativního znamení podněcují jedince k hledání nových, účinnějších způsobů, jak uspokojit potřeby a úspěšnějších objektů pro ně.
„Rozvoj osobnosti“ // Pro profesionály ve vědě a praxi. Pro ty, kteří jsou připraveni převzít zodpovědnost za výchovu a rozvoj osobnosti
V posilovacím učení je agent (zástupce) interaguje s prostředím (životní prostředí), podniknutí opatření (akce). Prostředí dává odměnu (odměna) pro tyto akce a agent je nadále provádí.
Semi-learningové algoritmy se snaží najít strategii, která přiřazuje stavy (uvádí) environmentální akce, z nichž si v těchto stavech může agent vybrat.
Rámec je obvykle formulován jako konečný stavový Markovův rozhodovací proces (MDP) a v tomto smyslu jsou algoritmy zesílení učení úzce spjaty s dynamickým programováním. Pravděpodobnosti výher a přechodů stavů v MPPR jsou obvykle náhodné hodnoty, ale stacionární v rámci problému.
V posilovacím učení, na rozdíl od učení pod dohledem, nejsou poskytovány správné dvojice vstup-odpověď a není výslovně omezeno přijímání neoptimálních rozhodnutí (uvádějících místní extrém). Posilovací učení se snaží najít kompromis mezi prozkoumáváním neprobádaných oblastí a aplikací existujících znalostí (průzkum vs vykořisťování). Rovnováha mezi učením a aplikací v posilovacím učení je zkoumána v problému mnohorukých banditů.
Formálně nejjednodušší model učení posilování se skládá z:
- soubory stavů prostředí (uvádí) [matematika]S[/matematika] ;
- soubor akcí (akce) [math]A[/math] ;
- sady skalárních „výplat“ v reálné hodnotě (Odměny).
V libovolném časovém okamžiku [matematika]t[/matematika] je agent charakterizován stavem [matematika]s_t v S[/matematika] a množinou možných akcí [matematika]A(s_t)[/matematika] . Výběrem akce [math]a v A(s_t)[/math] přejde do stavu [math]s_[/math] a obdrží výplatu [math]r_t[/math] . Na základě této interakce s prostředím musí výukový agent vyvinout strategii [math]pi: S až A[/math], která maximalizuje hodnotu [math]R=r_0 + r_1+cdots+r_n[/math] v v případě MPPR s koncovým stavem nebo hodnotou:
[math]R=součet_t gama^t r_t[/math] ,pro MPPR bez koncových stavů (kde [matematicky] 0 leq gama leq 1[/matematicky] je diskontní faktor pro „nadcházející zisk“).
Posilující učení je tedy zvláště vhodné pro problémy zahrnující kompromisy mezi dlouhodobými a krátkodobými zisky.
Prohlášení o problému posilování učení

Interakce agenta s okolím
[math]S[/math] — sada stavů prostředíHra na agenta s prostředím:
- inicializace strategie [math]pi_1(a | s)[/math] a stavu prostředí [math]s_1[/math] ;
- pro všechny [matematické] t = 1 ldots T[/matematické] :
- agent zvolí akci [matematický]a_t ∼ pi_t(a | s_t)[/matematický] ;
- prostředí vygeneruje odměnu [matematický]r_ ∼ p(r | a_t, s_t)[/matematický] a nový stav [matematický]s_ ∼ p(s | a_t, s_t)[/matematický] ;
- agent upraví strategii [math]pi_(a | s)[/math] .
Toto je Markovův rozhodovací proces (MDP), pokud [matematické] P(s_ = s′, r_ = r | s_t, a_t, r_t, s_, a_, r_, .. ,s_1, a_1) = P(s_ = s′ ,r_ = r |. s_t, a_t)[/math] ,
MPPR se nazývá konečný, jestliže [math]|A| lt infty[/math] , [math]|S| Je to hodně[/math]
Algoritmy
Nyní, když byla definována výplatní funkce, musíme definovat algoritmus, který bude použit k nalezení strategie, která poskytuje nejlepší výsledek.
Naivní přístup k řešení tohoto problému zahrnuje následující kroky:
- vyzkoušet všechny možné strategie;
- zvolit strategii s nejvyšší očekávanou návratností.
Prvním problémem tohoto přístupu je, že počet dostupných strategií může být velmi velký nebo nekonečný. Druhý problém nastává, pokud jsou výnosy stochastické – abyste mohli přesně odhadnout výnos z každé strategie, budete muset každou z nich použít mnohokrát. Těmto problémům se lze vyhnout tím, že se umožní určitá struktura a možná se umožní, aby výsledky získané při zkoušení jedné strategie ovlivnily hodnocení jiné. Dva hlavní přístupy k realizaci těchto myšlenek jsou odhad funkcí užitku a přímá optimalizace strategií.
Přístup funkce užitku používá více odhadů očekávaného výnosu pouze pro jednu [matematické]pi[/matematické] strategii (buď aktuální nebo optimální). V tomto případě se snaží odhadnout buď očekávanou výplatu, počínaje stavem [math]s[/math] , při dalším sledování strategie [math]pi[/math] ,
[math]V(s) = E[R|s, pi][/math] ,nebo očekávaný výnos při rozhodování [matematika]a[/matematika] ve státě [matematika]s[/matematika] a dalším sledování [math]pi[/math] ,
[matematické] Q(s, a) = E[R|s, pí, a][/matematické] ,Pokud se k výběru optimální strategie použije funkce užitku [math]Q[/math], pak lze vždy zvolit optimální akce jako akce maximalizující užitek.
Pokud použijeme funkci [math]V[/math] , je nutné buď mít model prostředí ve formě pravděpodobností [math]P(s’|s, a)[/math] , což nám umožňuje zkonstruovat užitnou funkci formy
nebo aplikovat tzv metoda performer-kritická, ve které je model rozdělen na dvě části: kritika, který hodnotí užitečnost stavu [matematický]V[/matematický], a interpreta, který v každém stavu vybírá vhodnou akci.
Vzhledem k pevné strategii [math]pi[/math] lze odhadnout [math]E[R|cdot][/math] pro [math]gamma = 1[/math] pouhým zprůměrováním okamžitých výnosů. Nejzřejmější způsob, jak odhadnout [matematické] gama v (0, 1)[/matematické], je zprůměrovat celkovou výplatu po každém stavu. To však vyžaduje, aby MPPR dosáhl koncového stavu (dokončeno).
Proto konstrukce požadovaného odhadu pro [math]gama v (0, 1)[/math] není zřejmá. Je však možné poznamenat, že [math]R[/math] tvoří rekurzivní Bellmanovu rovnici:
[math]E[R|s_t]=r_t + gama E[R|s_][/math] ,Nahrazením dostupných odhadů [math]V[/math] a aplikací metody gradientního sestupu s funkcí kvadratické chyby dospějeme k algoritmu učení s časovými efekty (časový rozdíl (TD) learning). V nejjednodušším případě jsou stavy i akce diskrétní a můžete se držet tabulkových odhadů pro každý stav.
Další podobné metody: Adaptivní heuristická kritika (AHC), SARSA a Q-learning.
Problém vícerukého bandity (Problém mnohorukých banditů)
Formulace
[math]A[/math] – sada možných akční (rukojeti kulometů), [math]p_a(r)[/math] – neznámá distribuce ocenění [matematika]r v R[/matematika] [matematika]forall a v A[/matematika] , [math]pi_t(a)[/math] — strategie agent v tuto chvíli [math]t[/math] [math]forall a in A[/math] .Hra na agenta s prostředím:
- inicializace strategie [math]pi_1(a)[/math] ;
- pro všechny [matematické] t = 1 ldots T[/matematické] :
- agent vybere akci (handle) [math]a_t ∼ pi_t(a)[/math] ;
- prostředí generuje odměnu [matematický]r_t ∼ p_(r)[/matematický] ;
- agent upraví strategii [math]pi_(a)[/math] .
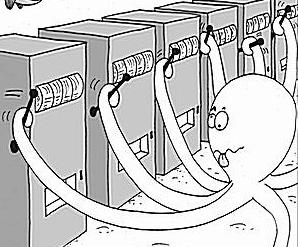
, [matematické]Q^∗(a) = lim limity_ Q_t(a) max. šipka vpravo [/matematické] — hodnota akce [matematické]a[/matematické] .Máme automat – [matematického]N[/matematického] -ozbrojeného banditu, při každém kroku volíme, kterou z [matematických]N[/matematických] klik automatu zatáhnout, tzn. sada akcí [matematika]A = [/matematika] .
Výběr akce [math]a_t[/math] v kroku [math]t[/math] znamená odměnu [math]R(a_t)[/math], zatímco [math]R(a)[/math] [math ]forall a v A[/math] je náhodná veličina, jejíž rozdělení není známo.
Stav našeho prostředí se nemění krok od kroku, což znamená, že množina stavů [math]S[/math] je triviální, nic neovlivňuje, takže ji lze ignorovat.
Pro jednoduchost budeme předpokládat, že každá akce odpovídá určitému rozdělení, které se v čase nemění. Pokud bychom znali tato rozdělení, zřejmou strategií by bylo vypočítat očekávanou hodnotu pro každé z rozdělení, vybrat akci s maximální očekávanou hodnotou a pak tuto akci provést v každém kroku.
Problém je v tom, že rozdělení jsou neznámá, ale je možné odhadnout matematické očekávání nějaké náhodné veličiny [math]xi[/math] s neznámým rozdělením. U [math]K[/math] experimentů [math]xi_k[/math] je odhad matematického očekávání aritmetickým průměrem experimentálních výsledků:
Problém je modelem pro pochopení konfliktu mezi vykořisťování–průzkum.
Chamtivé a [matematické] epsilon[/matematické] chamtivé strategie (chamtivý & [math]epsilon[/math] -chtivý)
Chamtivý (chamtivý) strategie
- [math]P_a = 0[/math] [math]forall a v [/math] – kolikrát byla vybrána akce [math]a[/math],
- [math]Q_a = 0[/math] [math]forall a v [/math] – aktuální odhad matematického očekávání odměny za akci [math]a[/math] .
Na každém kroku [math]t[/math]
- Vybíráme akci s maximálním matematickým odhadem očekávání:
- Proveďte akci [math]a_t[/math] a získejte odměnu [math]R(a_t)[/math] ;
- Aktualizujeme matematický odhad očekávání pro akci [math]a_t[/math] :
Mějme „dvourukého“ banditu. První rukojeť vždy dává odměnu rovnou 1, druhá vždy dává 2. Podle chamtivé strategie zatáhneme za první rukojeť na začátku, protože na začátku jsou odhady matematických očekávání rovny nule, budeme zvýšit jeho odhad na [matematický]Q_1 = 1[/matematický] . V budoucnu budeme vždy volit první rukojeť, což znamená, že na každém kroku dostaneme o 1 méně, než bychom mohli.
V tomto případě stačí na začátku vyzkoušet každou z rukojetí místo toho, abyste se soustředili pouze na jednu. Pokud je ale odměna náhodná, pak jediný pokus stačit nebude. Proto upravujeme chamtivou strategii následovně:
[math]epsilon[/math] -chtivý ( [math]epsilon[/math] —chamtivý) strategie

Příklad. Odměna za strategii s různými [matematickými]epsilon[/matematickými]
Zaveďme parametr [math]epsilon v (0,1)[/math] .
Na každém kroku [math]t[/math]
- Získáme hodnotu [math]alpha[/math] – náhodná veličina rovnoměrně rozložená na intervalu [math](0, 1)[/math] ;
- Pokud [math]alpha v (0, epsilon)[/math] , pak akci [math]a_t v A[/math] vybereme náhodně a stejně pravděpodobně, jinak, stejně jako v chamtivé strategii, vybereme akci s maximální odhad matematického očekávání;
- Odhady aktualizujeme stejným způsobem jako v chamtivé strategii.
Pokud [math]epsilon = 0[/math] , pak je to běžná chamtivá strategie. Pokud však [math]epsilon gt 0[/math] , pak na rozdíl od chamtivé strategie v každém kroku s pravděpodobností [math]epsilon[/math] dochází k „exploraci“ náhodných akcí.
Strategie Softmax
Hlavní myšlenka algoritmu softmax — snížení ztrát během výzkumu v důsledku méně častého výběru akcí, které byly v minulosti málo odměněny. Aby toho bylo dosaženo, je pro každou akci vypočítán váhový koeficient, na jehož základě je akce vybrána. Čím větší [math]Q_t(a)[/math] , tím větší je pravděpodobnost výběru [math]a[/math] :
[math]tau v (0, infty)[/math] je parametr, který lze použít ke konfiguraci chování algoritmu.S [math]tau rightarrow infty[/math] bývá strategie jednotná, to znamená, že softmax bude méně záviset na hodnotě výplaty a bude volit akce rovnoměrněji (exploration).
Když [math]tau rightarrow 0[/math] strategie má tendenci být chamtivá, to znamená, že algoritmus bude více zaměřený na známou průměrnou výplatu akcí (vykořisťování).
Exponent se používá k tomu, aby tato váha byla nenulová i u akcí, jejichž odměna je stále nulová.
Heuristika: má smysl snižovat parametr [math]tau[/math] v průběhu času.
metoda UCB (horní hranice důvěry)
Předchozí algoritmy používají při rozhodování data o průměrných výhrách. Problém je v tom, že pokud akce dává odměnu s určitou pravděpodobností, pak jsou pozorovací data hlučná a můžeme nesprávně určit nejziskovější akci.
Algoritmus horního intervalu spolehlivosti (horní hranice důvěry nebo UCB) je rodina algoritmů, které se snaží tento problém vyřešit pomocí dat nejen o průměrných výhrách, ale také o tom, jak moc můžete výherním hodnotám věřit.
Stejně jako softmax v UCB se při výběru akce používá váhový koeficient, který představuje horní hranici spolehlivosti hodnoty výplaty:
[math]pi_(a) = Q_t(a) + b_a[/math] , [math]b_a = sqrt>> [/math] – bonusová hodnota, která ukazuje, jak málo je akce prozkoumaná ve srovnání s ostatními.Na rozdíl od předchozích algoritmů UCB nepoužívá k výběru akce náhodná čísla ani parametry, které mohou ovlivnit její činnost. Na začátku algoritmu je každá z akcí vybrána jednou (aby bylo možné vypočítat velikost bonusu pro všechny akce). Poté je v každém časovém okamžiku vybrána akce s maximální hodnotou váhového koeficientu.
Navzdory tomuto nedostatku náhodnosti jsou výsledky tohoto algoritmu ve srovnání s jinými poměrně zašuměné. Je to dáno tím, že tento algoritmus poměrně často vybírá nedostatečně prozkoumané akce.
Q-učení
Na základě odměny obdržené od okolí si agent zformuje užitkovou funkci [math]Q[/math] , která mu následně dává možnost nevolit náhodně strategii chování, ale zohlednit zkušenosti z předchozí interakce s prostředí. Jednou z výhod [math]Q[/math] -learningu je, že je schopen porovnávat očekávanou užitečnost dostupných akcí, aniž by tvořil model prostředí. Používá se pro situace, které mohou být reprezentovány jako MPPR.
Algoritmus je tedy funkcí kvality ze stavu a akce:
[math]Q: S krát A na mathbb[/math] ,Před trénováním se [math]Q[/math] inicializuje náhodnými hodnotami. Poté v každém časovém okamžiku [math]t[/math] agent zvolí akci [math]a_t[/math] , obdrží odměnu [math]r_t[/math] , přejde do nového stavu [math] s_[/math] , který může záviset na předchozím stavu [math]s_t[/math] a vybrané akci, a aktualizuje funkci [math]Q[/math] . Aktualizace funkce používá vážený průměr mezi starou a novou hodnotou:
kde [math]r_[/math] je odměna obdržená při přechodu ze stavu [math]s_[/math] do stavu [math]s_[/math] a [math]alpha[/math] je rychlost učení ( [math]0 lt alpha le 1[/ matematika]).
Algoritmus končí, když agent vstoupí do terminálního stavu [math]s_[/math] .
Algoritmus Q-learningu

- [math]S[/math] — sada stavů,
- [math]A[/math] – mnoho akcí,
- [math]R = S krát A rightarrow mathbb[/math] – funkce odměny,
- [math]T = S krát A šipka vpravo S[/math] – přechodová funkce,
- [math]alpha in [0, 1][/math] — rychlost učení (obvykle 0.1), čím vyšší je, tím více agent důvěřuje novým informacím,
- [math]gamma v [0, 1][/math] – diskontní faktor, čím je menší, tím méně agent přemýšlí o výhodách svého budoucího jednání.
zábava Q-learning (): for : for : Q(s, a) = rand() zatímco Q není konvergované: s = zatímco s není terminál: = r = R(s, a) s' = T(s, a) s = s' návrat Q
reference
- Wikipedia: Posílení učení
- Sutton, Richard S. a Andrew G. Barto. Úvod do posilovacího učení. sv. 135. Cambridge: MIT press, 1998.
- Sutton RS, Barto AG Posílení vzdělávání: Úvod. – 2011.
- Posílení učení
- Mnohoruký bandita
- Problém mnohorukého bandity
- Posílení učení K.V
- Recenze knihy „Bandit Algorithms for Website Optimization“
- Q-učení
- Úvod do Q-Learning: posílení učení
- Strojové učení
- Posílení učení

